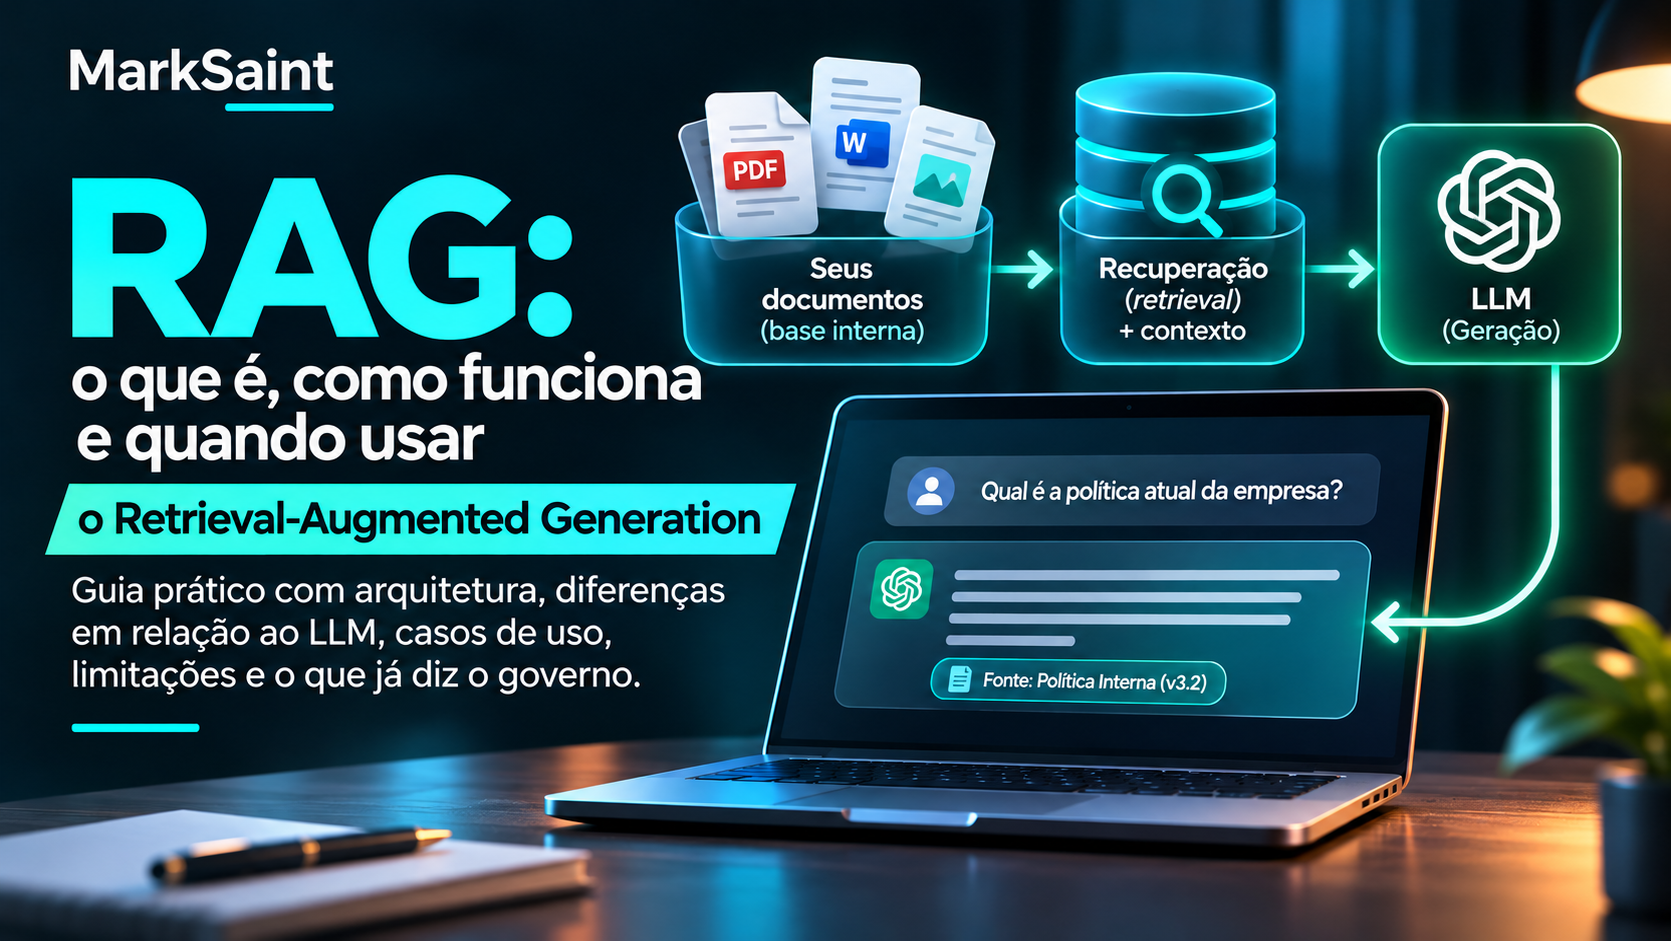
RAG é a arquitetura que faz um modelo de linguagem consultar os documentos da sua organização antes de responder, em vez de responder pela memória do treino. A definição cabe numa linha e é por isso que a primeira página do Google tem oito versões dela, quase todas iguais.
Este guia parte dessa definição e vai além dela: como a arquitetura se divide na prática, quando RAG é a escolha errada, o que o governo brasileiro já publicou sobre o assunto, e o que os artigos de 2026 mostraram sobre escala, agentes e envenenamento de base. Cada pesquisa citada aqui foi aberta na fonte, com autores e data conferidos.
Seção 03
O que significa RAG?
RAG significa Retrieval-Augmented Generation, em português Geração Aumentada por Recuperação. É uma arquitetura em que o sistema busca trechos relevantes numa base de documentos confiáveis e os envia ao modelo de linguagem junto com a pergunta, para que a resposta seja formulada a partir dessas fontes e possa citá-las.
O termo nasceu no artigo Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, de Patrick Lewis e outros onze autores, submetido ao arXiv em 22 de maio de 2020 e apresentado na NeurIPS daquele ano. Seis anos depois, a definição que circula no Google é fiel ao artigo original.
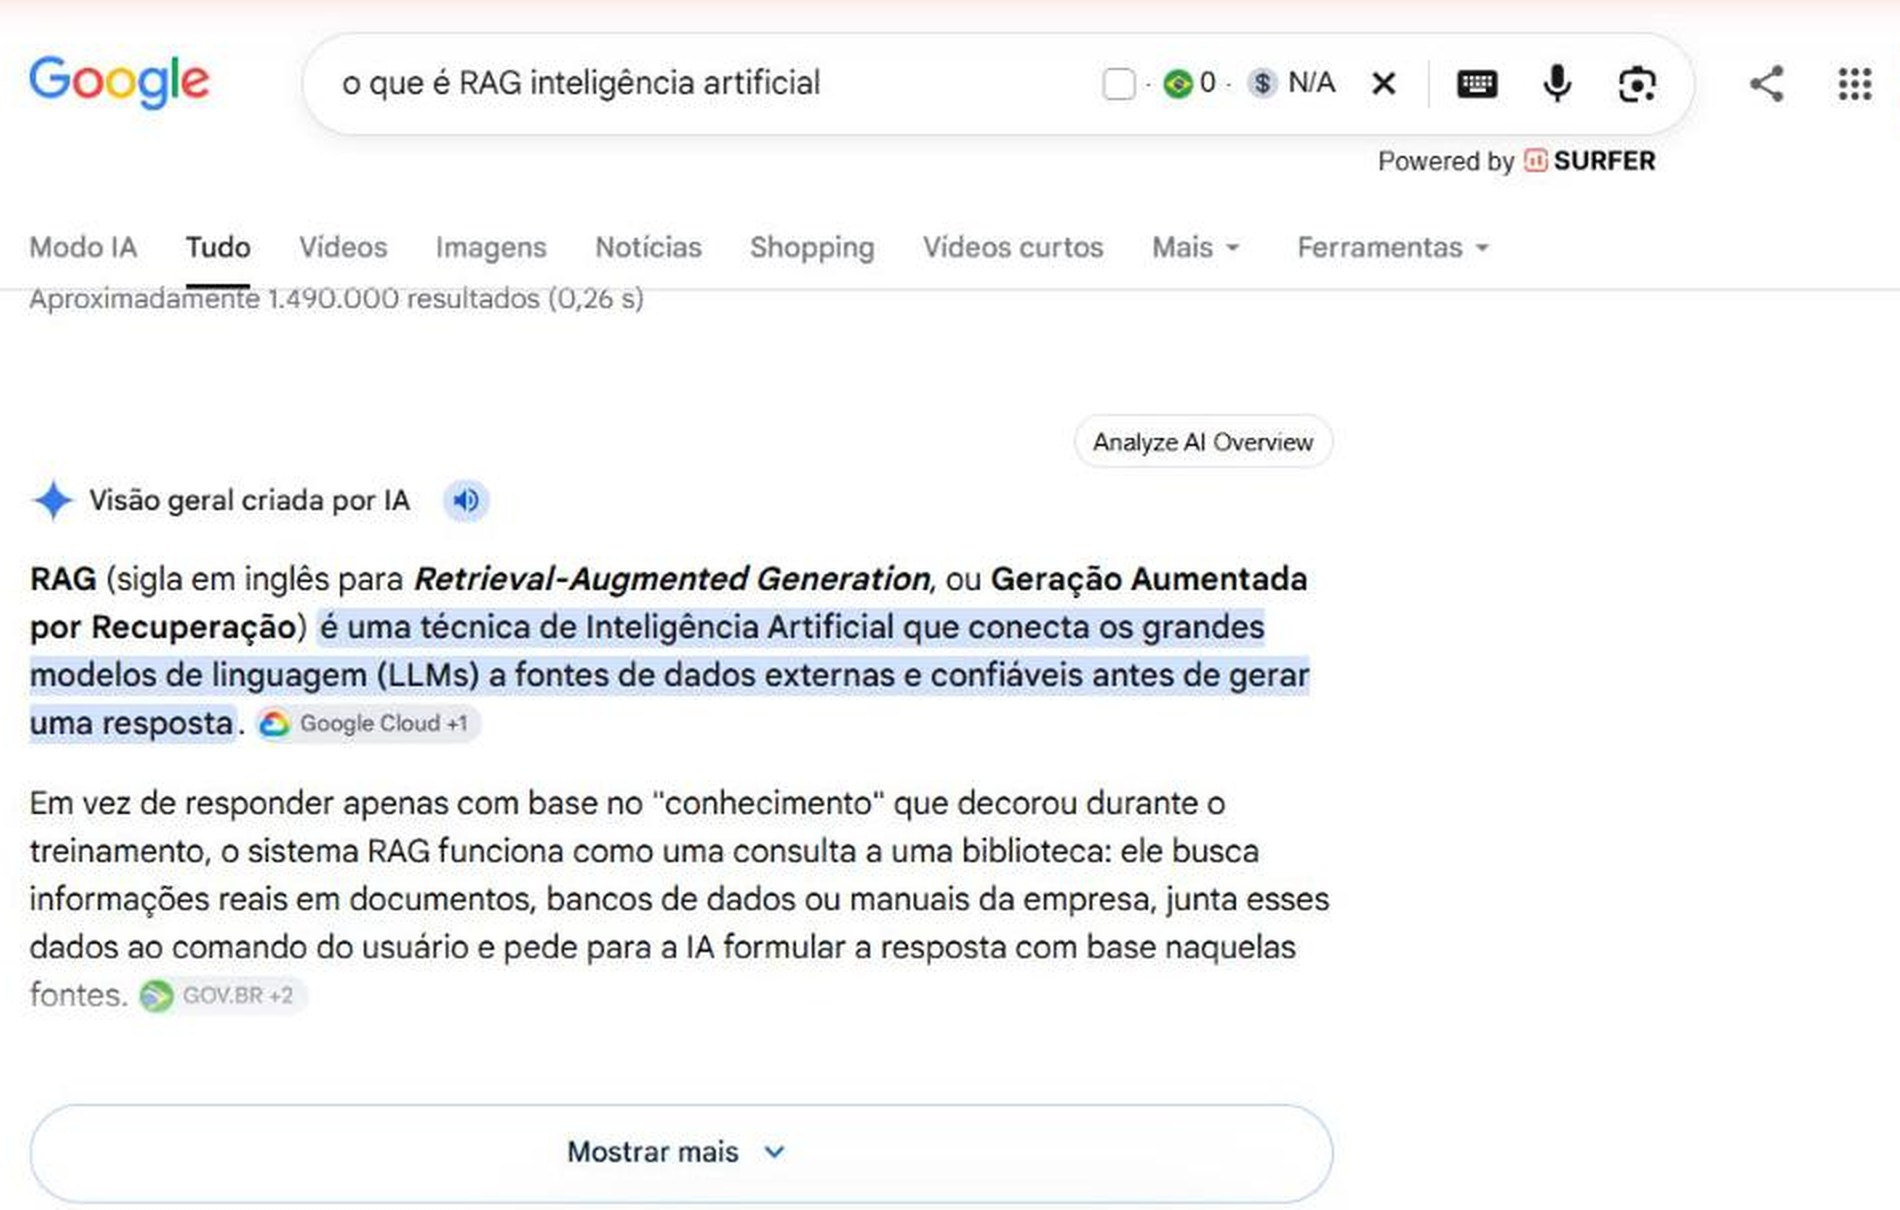
A Visão Geral criada por IA do Google para "o que é RAG inteligência artificial". Captura de 08/11/2026.
As perguntas que o público realmente faz, no bloco de perguntas relacionadas, vão além da definição.
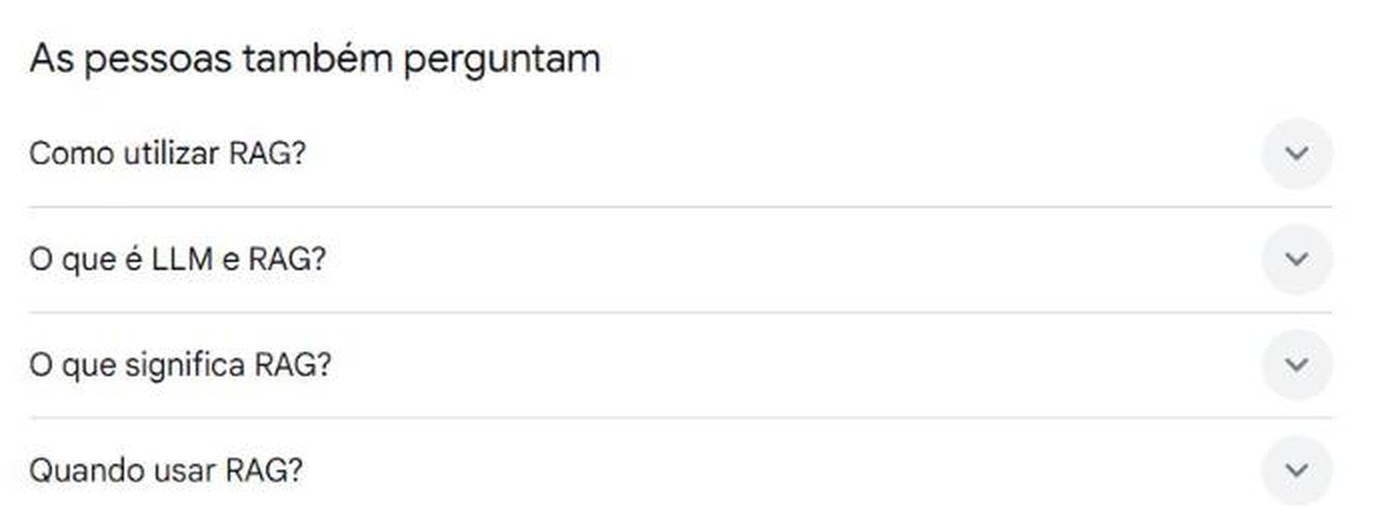
People Also Ask para "o que é RAG inteligência artificial". Google Brasil, captura de 08/11/2026. Os títulos das seções deste guia seguem essas perguntas.
Seção 04
Como o RAG funciona na prática?
A confusão mais cara em projetos de RAG vem de tratar o sistema como uma coisa só. São duas metades, com donos, custos e frequências diferentes.
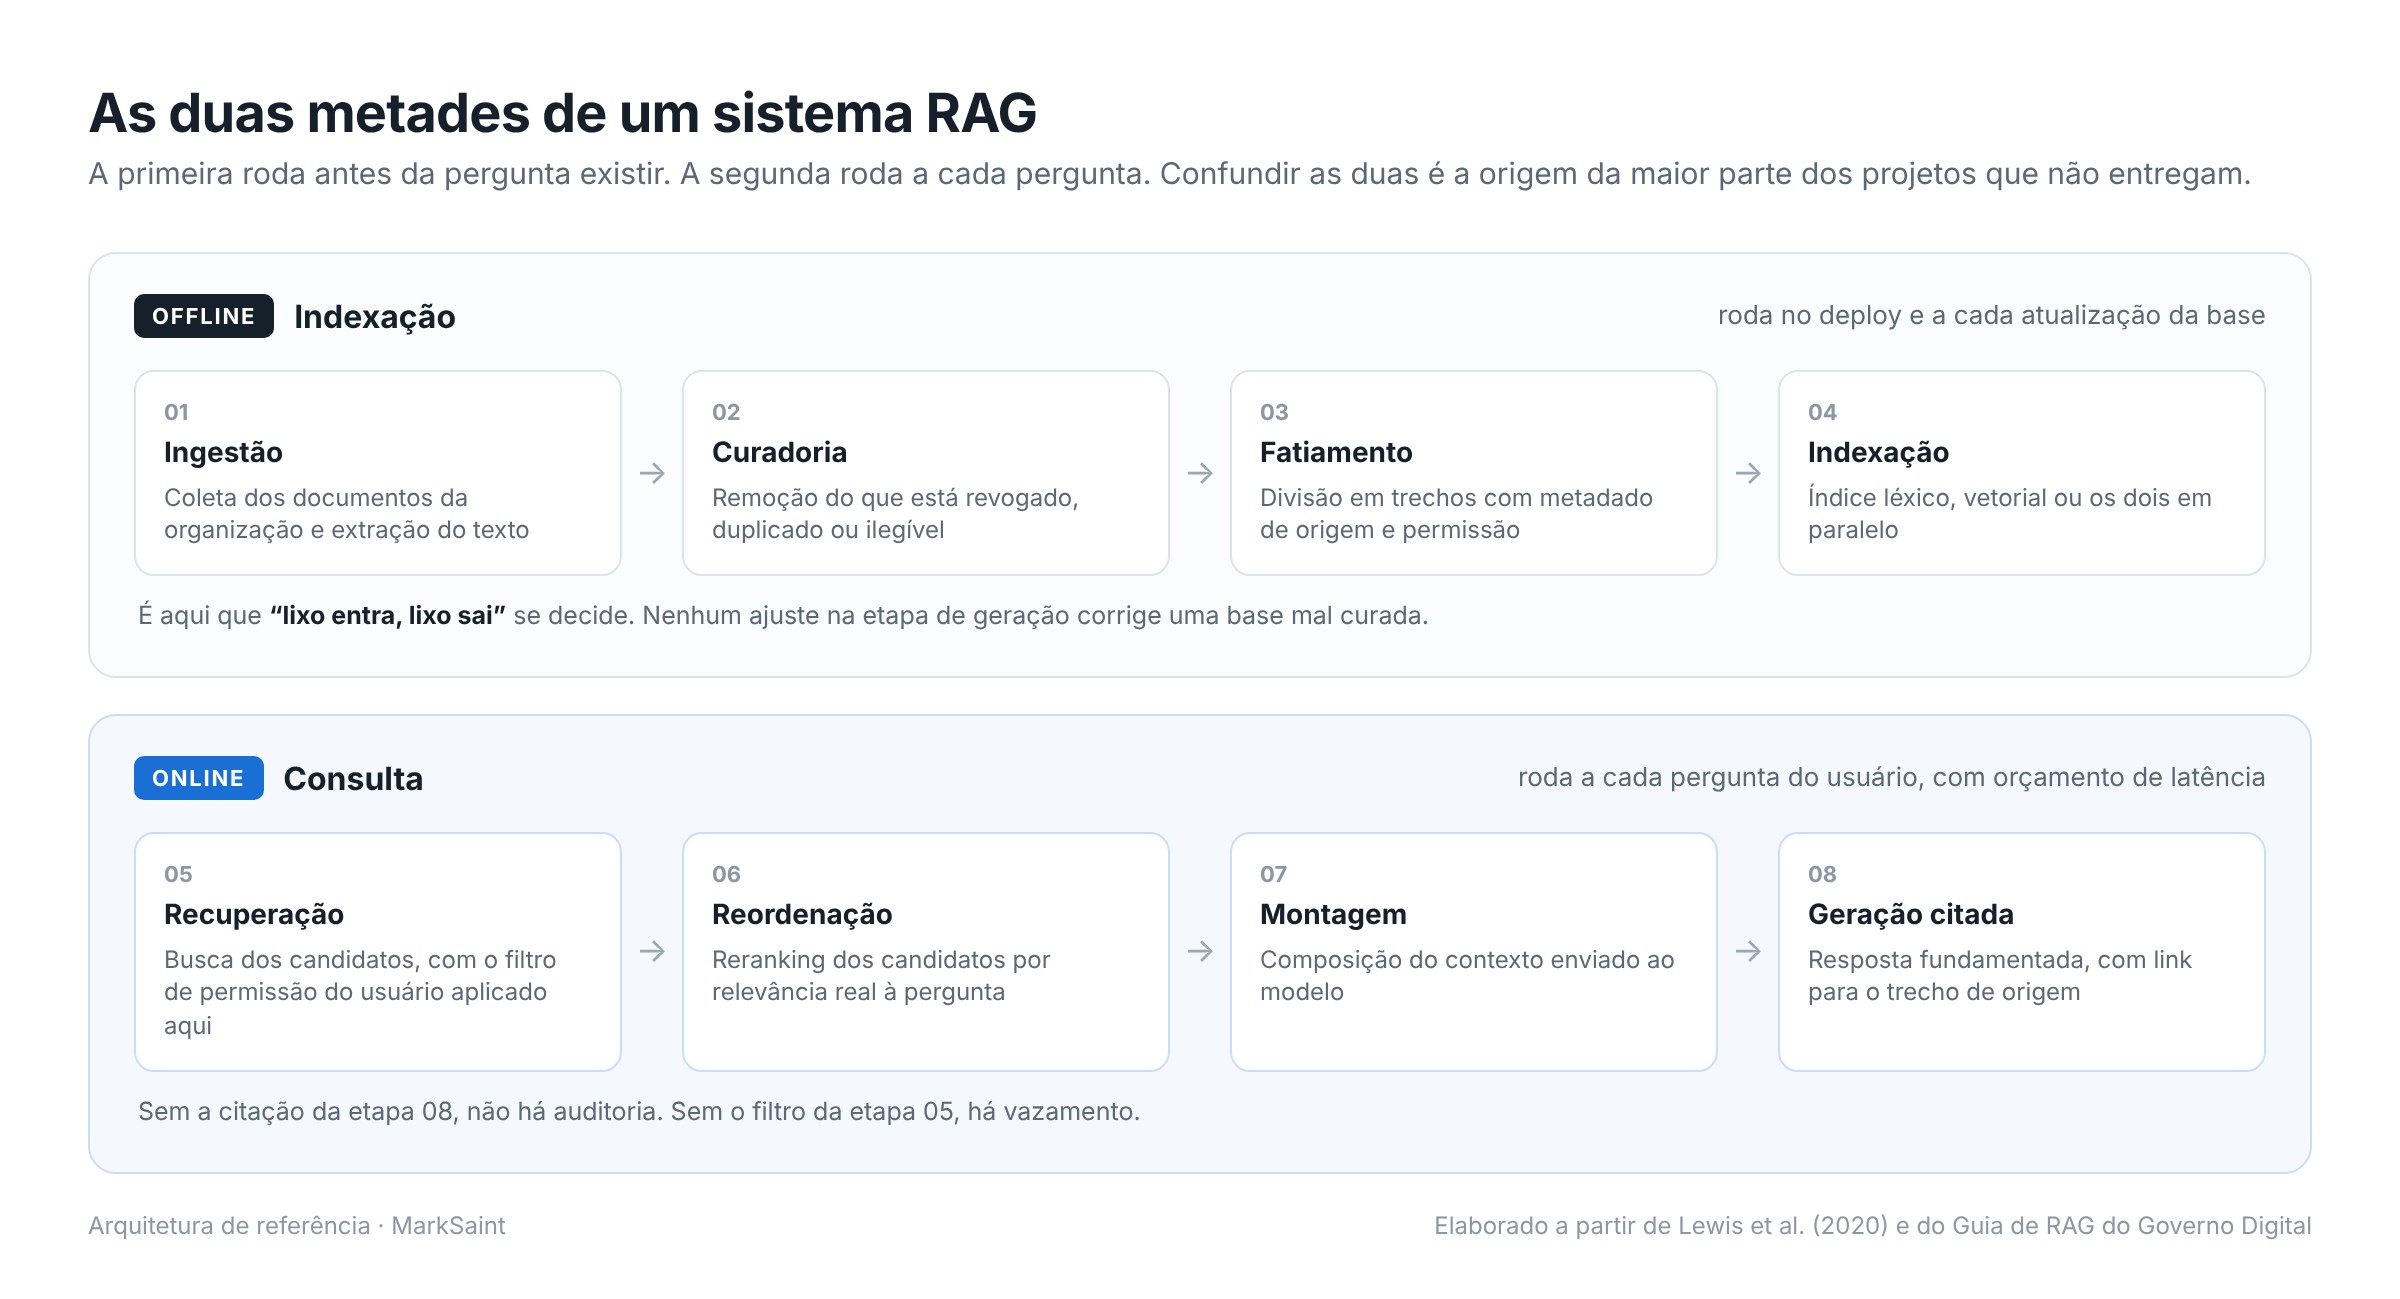
As oito etapas de um sistema RAG, separadas pela fase em que rodam.
A metade offline: indexação
Roda antes de qualquer pergunta existir e se repete a cada atualização da base. Quatro etapas: ingestão dos documentos, curadoria do que entra, fatiamento em trechos com metadado de origem e permissão, e construção do índice.
É nessa metade que a maior parte dos projetos falha, e a falha quase nunca é técnica. Um PDF escaneado sem camada de texto, uma portaria revogada que ninguém tirou da pasta, duas versões do mesmo manual com números diferentes: o sistema vai recuperar tudo isso com a mesma confiança. O índice não sabe o que está revogado.
A metade online: consulta
Roda a cada pergunta, dentro de um orçamento de latência. Recuperação dos candidatos, reordenação por relevância, montagem do contexto e geração da resposta com citação.
Dois pontos dessa metade decidem se o sistema serve para uso corporativo. O filtro de permissão precisa ser aplicado na recuperação, não depois: se o modelo leu o documento, o conteúdo já pode vazar na resposta, por mais que a interface esconda o link. E a citação da fonte precisa existir, porque sem ela não há como auditar nem como o usuário conferir.
Seção 07
O que é LLM e RAG?
O LLM é o modelo que escreve. O RAG é o que ele lê antes de escrever. Um LLM sozinho responde com o que absorveu no treino, que tem data de corte e não inclui os documentos da sua empresa. O RAG não melhora o modelo, ele muda o que entra no contexto dele.
O Governo Digital resume a diferença numa tabela que vale reproduzir, porque é a formulação mais clara em português que encontrei.
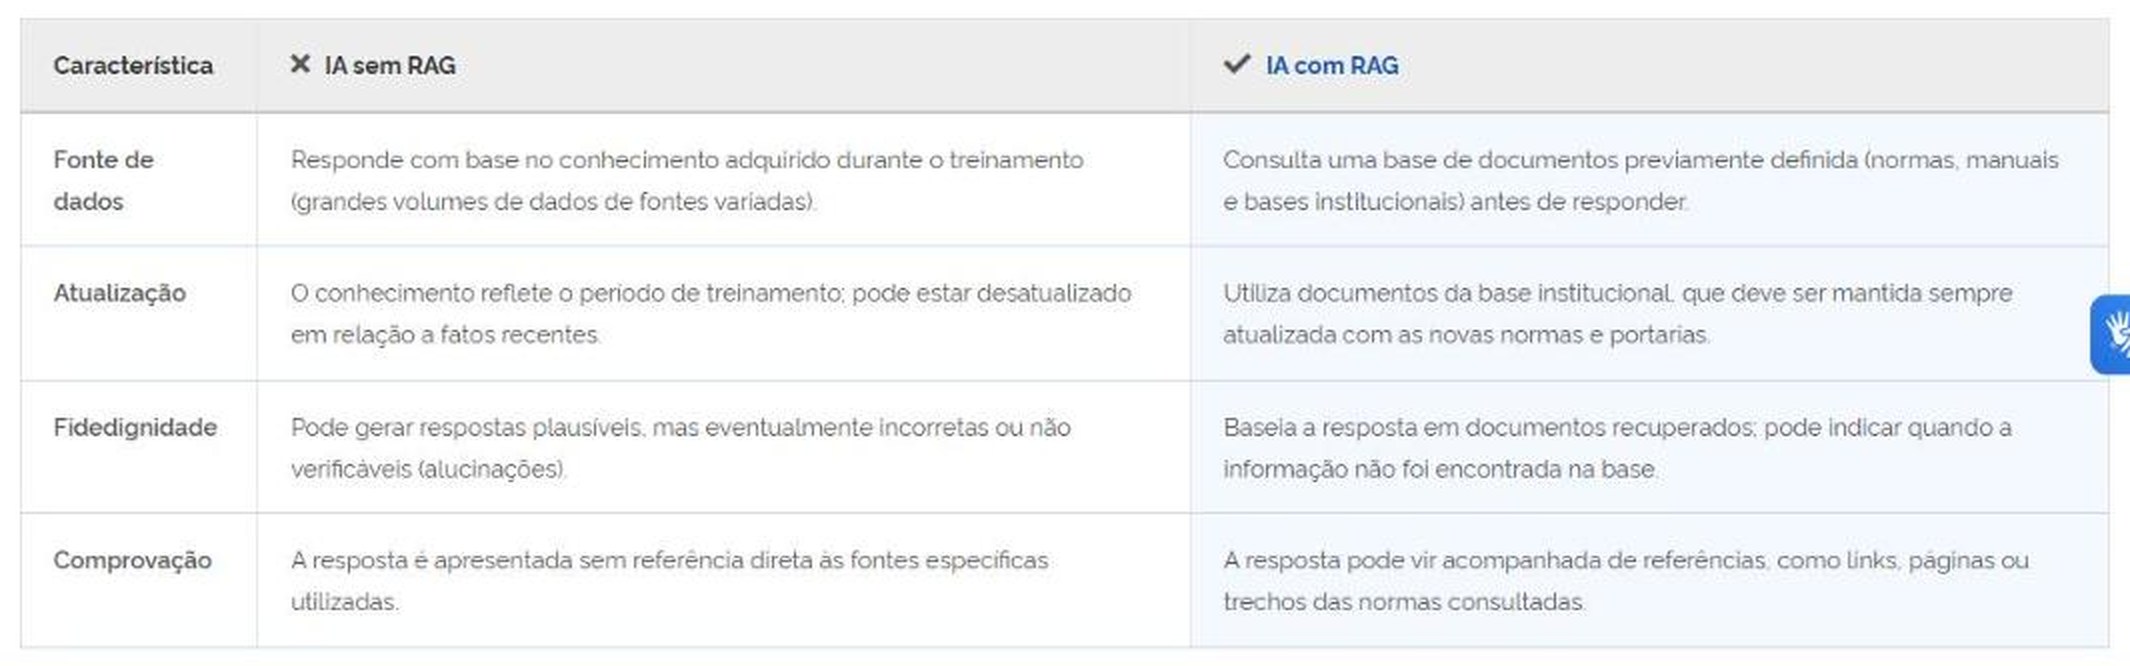
Comparação do Guia de Introdução ao RAG no Setor Público, Governo Digital. Captura de 08/11/2026.
A linha mais importante é a última. Sem RAG, a resposta vem sem referência à fonte. Com RAG, a resposta pode vir com link, página ou trecho da norma consultada. Para qualquer uso corporativo com consequência jurídica, essa linha é a que decide a compra.
Seção 08
Quando usar RAG?
RAG resolve um problema específico, e é vendido como se resolvesse quatro. Vale separar.
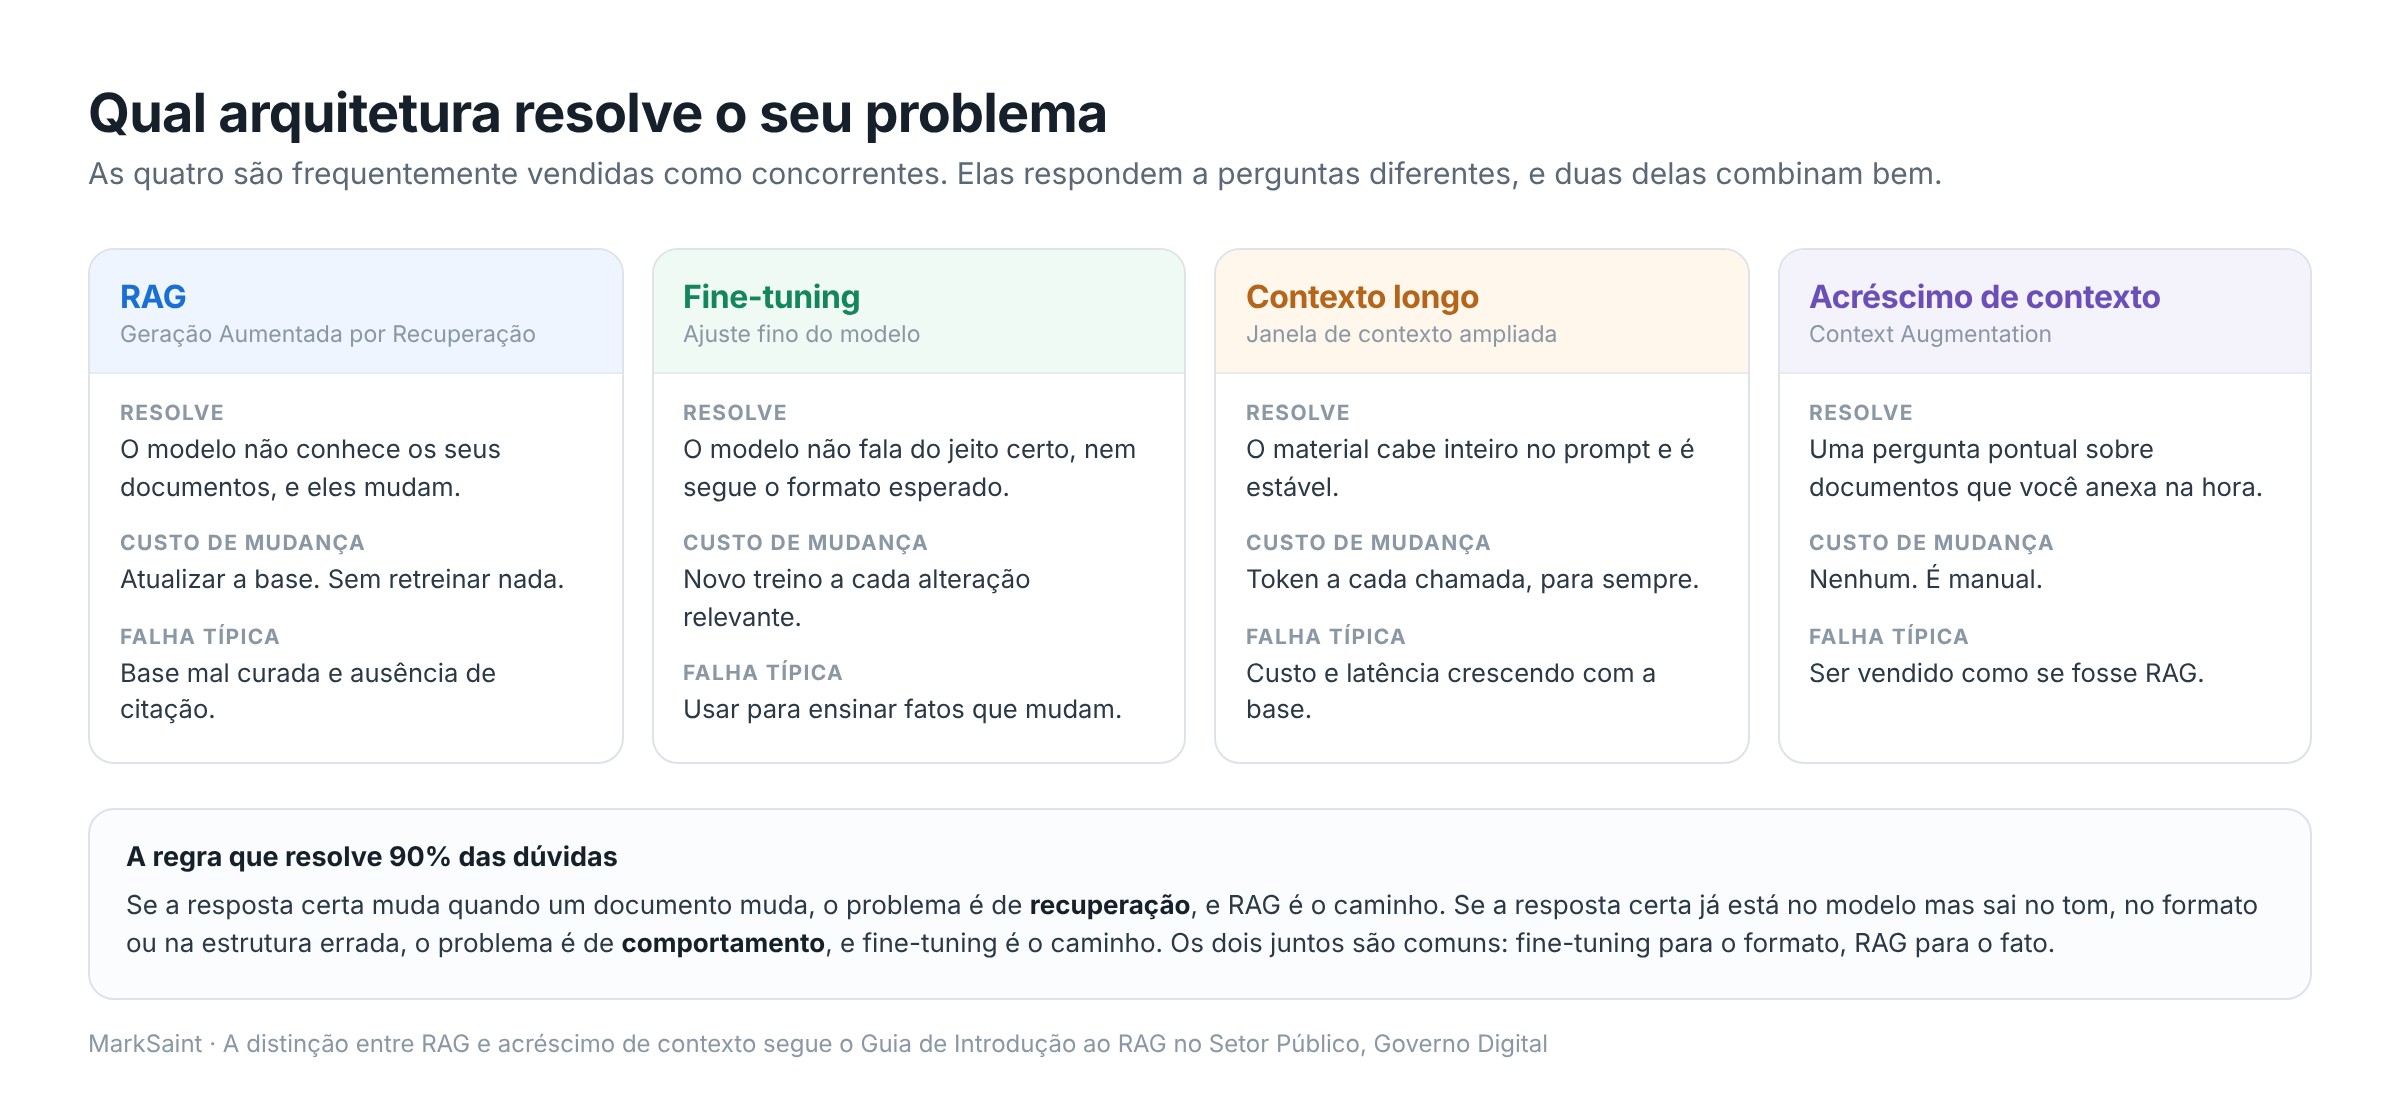
As quatro abordagens e o que cada uma resolve de fato.
Quando usar RAG e quando usar fine-tuning?
A regra prática: se a resposta certa muda quando um documento muda, o problema é de recuperação e RAG resolve. Se a resposta certa já está no modelo mas sai no tom, no formato ou na estrutura errada, o problema é de comportamento e fine-tuning resolve.
Usar fine-tuning para ensinar fatos que mudam é o erro mais caro do conjunto, porque cada mudança de norma vira um novo ciclo de treino. Os dois juntos são comuns e fazem sentido: fine-tuning para o formato, RAG para o fato.
E o contexto longo não resolveu isso?
Janelas de contexto grandes resolvem o caso em que o material cabe inteiro no prompt e é estável. O custo, porém, é cobrado a cada chamada e cresce com o tamanho do material, enquanto o custo do índice é pago uma vez e amortizado. Para uma base corporativa que muda toda semana, o contexto longo é a opção mais cara a médio prazo.
Há também o caso que o Governo Digital nomeia com precisão: quando a pessoa reúne documentos e cola no prompt, isso é acréscimo de contexto, não RAG. A distinção importa na hora de contratar, porque o preço das duas coisas não é o mesmo.
Seção 11
Como utilizar RAG?
Para quem vai usar um sistema pronto, três hábitos resolvem a maior parte dos erros: conferir a fonte citada antes de usar a resposta, desconfiar de resposta sem citação, e tratar o resultado como rascunho fundamentado, não como decisão.
Para quem vai implementar, a ordem que funciona é inversa à intuição. Comece pela curadoria da base, não pela escolha do banco vetorial. Defina o conjunto de perguntas reais que o sistema precisa acertar e as respostas corretas para elas antes de escrever código, porque sem esse conjunto não existe como medir se uma mudança melhorou ou piorou o sistema.
Só depois venha a escolha do método de recuperação. E aqui 2026 trouxe o achado que mais contraria o senso comum do mercado.
Seção 12
O que as pesquisas de 2026 mostraram sobre RAG?
Três artigos publicados neste ano mudam recomendações práticas. Todos foram abertos no arXiv e conferidos.
Aplique isso no seu negócio
Quer saber como implementar essas estratégias na prática? Nossa equipe analisa seu site gratuitamente e monta um plano de ação personalizado.
Busca léxica vence em escala
Em BM25 Wins at Scale: A Scaling Study of Retrieval-Augmented Generation Paradigms, submetido em 29 de julho de 2026, Pengyu Wang e colegas comparam recuperação léxica, densa, baseada em grafo e agêntica num mesmo experimento controlado, com 28 níveis de corpus aninhados que cobrem uma faixa de cerca de 450 vezes em tamanho.
O resultado não é um vencedor único, é um cruzamento. O agente de sistema de arquivos lidera nos corpora menores e perde terreno conforme a base cresce. O BM25 ultrapassa o agente por volta de 10 milhões de tokens de corpus e lidera em todos os níveis acima disso, com margem de acurácia chegando perto de 20 pontos na escala cheia. O agente consome 39 vezes mais tokens de consulta no nível de referência.
A conclusão dos autores é direta: recuperação léxica é o padrão escalável mais forte, e raciocínio agêntico funciona melhor aplicado depois da recuperação ordenada, não no lugar dela. Para quem monta orçamento, isso significa que o BM25 que parecia antiquado continua sendo a linha de base a bater.
Agentes ganham onde a base é pequena
Isso não invalida a linha agêntica. Em A-RAG: Scaling Agentic Retrieval-Augmented Generation via Hierarchical Retrieval Interfaces, de fevereiro de 2026, Mingxuan Du e colegas dão ao modelo acesso direto a três ferramentas de recuperação, busca por palavra-chave, busca semântica e leitura de trechos individuais, e relatam desempenho superior com volume igual ou menor de tokens recuperados.
Vale notar que quatro autores assinam os dois artigos. O mesmo grupo que propôs a arquitetura agêntica publicou, cinco meses depois, o estudo que mostra onde ela deixa de compensar. Isso é o oposto do que se espera de marketing de fornecedor, e é um bom motivo para levar os dois resultados a sério.
Do lado corporativo, AgenticRAG: Agentic Retrieval for Enterprise Knowledge Bases, de maio de 2026, relata 49,6% de recall@1 no BRIGHT, 21,8 pontos acima da melhor linha de base por embedding, 0,96 de factualidade no WixQA e 92% de correção de resposta no FinanceBench, a dois pontos do acesso oracular à evidência correta. A ablação aponta a troca de recuperação em passe único por uso agêntico de ferramentas como o fator de maior peso.
Cinco documentos envenenados derrubam a recuperação
O achado mais desconfortável do ano é de segurança. Em Reliability Stress Testing of RAG Retrieval under Query-Relevant Corpus Poisoning, submetido em 3 de novembro de 2026, Janet Sung, Kainan Zhou, Gangzhen Qian, Hang Xiao e Lu Yi testam o que acontece quando alguém insere documentos feitos sob medida para uma consulta específica.
Em 623 consultas do BEIR, nos conjuntos SciFact e NFCorpus, cinco documentos construídos para uma consulta reduzem o nDCG@10 de recuperadores clássicos entre 40,2% e 61,5%. Num modelo denso pré-treinado, a exposição do alvo chega a 100%. Os autores mostram que ancorar o texto na consulta completa explica a maior parte da degradação.
A leitura prática: a base de conhecimento de um RAG é uma superfície de ataque, e cinco arquivos bastam. Isso vale para qualquer sistema que aceite ingestão de documentos de fora, inclusive de fornecedores, parceiros ou formulários de clientes. É a mesma lógica que descrevemos em SEO social parasita, aplicada à camada de recuperação em vez da camada de busca pública.
Seção 16
O que o governo brasileiro recomenda sobre RAG?
O Governo Digital publicou o Guia de Introdução ao RAG no Setor Público, e ele é mais útil que boa parte do material comercial disponível em português. Três pontos merecem leitura mesmo fora do setor público.
Lixo entra, lixo sai. O guia é explícito sobre a qualidade documental e propõe quatro critérios para o que entra na base: precisão, completude, consistência e atualização. Documentos revogados devem sair da biblioteca ativa.
Supervisão humana. A formulação do guia é que a IA não decide, ela sugere, e a responsabilidade legal permanece com o agente público. A tradução corporativa é direta: o sistema produz rascunho fundamentado, a assinatura continua sendo de uma pessoa.
Dados pessoais acionam a LGPD. Quando a base contém nome, CPF, e-mail ou qualquer dado que identifique alguém, o sistema passa a realizar tratamento de dados pessoais, e valem os princípios do Art. 6º: finalidade, necessidade, livre acesso, qualidade, segurança, não discriminação e responsabilização. O guia recomenda avaliar anonimização ou pseudonimização quando a identificação não for essencial, sem tratá-la como solução automática.
O guia também lista riscos que raramente aparecem em proposta comercial: exposição indevida ao centralizar documentos, controle de acesso inadequado, registros de interação trafegando por terceiros, e conteúdo manipulado influenciando respostas. Esse último item é exatamente o ataque que o artigo de novembro mediu.
Seção 17
O que é RAG na saúde e em setores regulados?
Setores regulados são onde a citação da fonte deixa de ser conveniência e vira requisito. Em saúde, jurídico, financeiro e setor público, uma resposta sem rastro de origem não pode fundamentar decisão, por mais correta que esteja.
Isso muda a ordem de prioridade do projeto. Em um produto de consumo, recuperar bem é o que importa. Em um ambiente regulado, recuperar bem é metade: a outra metade é provar de onde veio, manter registro de quem consultou o quê, e respeitar o nível de permissão de cada usuário na própria recuperação.
A pesquisa acadêmica de 2026 acompanhou esse movimento, com trabalhos aplicando RAG a domínios clínicos específicos e a estimativa nutricional por imagem, entre outros. O padrão comum é o mesmo: recuperar exemplos verificados e usá-los como evidência, em vez de confiar no que o modelo acha que sabe.
Seção 18
Como implementar RAG sem errar o básico?
Uma sequência que evita os erros mais comuns, na ordem.
- 1
Escreva o conjunto de avaliação primeiro. Trinta a cem perguntas reais com as respostas corretas e o documento que as fundamenta. Sem isso, nenhuma mudança posterior é mensurável.
- 2
Cure a base antes de indexar. Remova revogados, duplicados e arquivos ilegíveis. Registre a data de vigência de cada documento como metadado.
- 3
Comece pelo BM25. É barato, é interpretável e, pelo estudo de escala de 2026, é a linha de base que métodos mais caros precisam superar. Meça antes de trocar.
- 4
Acrescente recuperação densa em paralelo, não no lugar. A combinação cobre sinônimos e paráfrases que o léxico perde.
- 5
Coloque reordenação antes da geração. Ganho de qualidade alto para custo baixo, e é onde o raciocínio agêntico rende mais, segundo o mesmo estudo.
- 6
Aplique permissão na recuperação. Nunca depois. Se o modelo leu, considere vazado.
- 7
Exija citação na saída. Resposta sem fonte não entra em produção em ambiente com consequência.
- 8
Trate a ingestão como superfície de ataque. Controle quem pode inserir documento na base e registre a origem de cada arquivo.
Seção 19
Quanto custa manter um sistema RAG?
O custo que aparece na proposta é o da construção. O que decide se o projeto sobrevive é o de manutenção, e ele tem três componentes que costumam ficar de fora.
O primeiro é a curadoria contínua da base. É trabalho humano recorrente e não tem como ser terceirizado para o modelo.
O segundo é o custo por consulta, que cresce com a quantidade de tokens enviados ao modelo. Ele explode quando a arquitetura faz muitas chamadas por pergunta, como mostram os 39 vezes mais tokens de consulta do agente no estudo de escala.
O terceiro é a reavaliação periódica. Mudança de modelo, de base ou de método de recuperação pede rodar o conjunto de avaliação de novo.
Um fornecedor que não menciona esses três itens na proposta está orçando a construção de uma biblioteca e não a operação dela.
Seção 20
O que fica
RAG deixou de ser novidade e virou infraestrutura. A discussão madura de 2026 não é se vale a pena, é qual método de recuperação cabe no tamanho da sua base, quanto custa manter a base limpa, e quem responde quando a resposta sai errada.
Os três achados deste ano apontam na mesma direção prática: comece simples e meça, porque o método mais caro nem sempre vence; aplique inteligência depois da recuperação, não no lugar dela; e trate a base de conhecimento com o mesmo cuidado de segurança que você daria a um banco de dados de produção, porque cinco arquivos bastam para comprometê-la.
Está avaliando um projeto de IA com RAG? A MarkSaint ajuda a separar o que é arquitetura do que é nome comercial na proposta, e a definir o conjunto de avaliação antes de assinar. Peça o diagnóstico gratuito.